 物流・倉庫の物量予測AI
回帰モデルは、当てたい数字を、それを動かしている手がかりの数字の足し算で表した式のことです。物流の現場に置き換えると、翌日の出荷ケース数を、前日に入った通販の受注件数や祝日かどうかといった情報から計算で出す道具になります。名前は難しく聞こえますが、Excelの散布図に近似曲線を1本引いたことがある方なら、すでに一番やさしい回帰モデルを使ったことがあります。考え方さえ押さえておけば、AIの予測が何をしているのかも、ずっと見通しがよくなります。
この記事では、手がかりが1つの単回帰と、手がかりを増やした重回帰の違いを、出荷ケース数を読む例で順に説明します。後半では、私たちが作った出荷のサンプルデータで回帰モデルを組んだ結果を見ながら、当たり具合の読み方と、回帰が外しやすい日の見分け方、Excelで試すときの手順までを扱います。統計の正式な用語は、本文ではできるだけ言い換え、必要なところだけ注記に回しました。
回帰モデルは、当てたい数字を手がかりの数字の足し算で表す式です
回帰モデルがやっていることは、過去の記録から「この手がかりが1増えると、結果がどれだけ動くか」を割り出し、それを式にまとめることです。たとえば出荷ケース数なら、前日の受注件数が1件増えるごとに何ケース増えるのか、祝日明けの日はふだんより何ケース多いのか、といった効き目を一つずつ数字にします。来週の受注の見込みや祝日の予定をその式に入れれば、出荷ケース数の予測が出てきます。結果と手がかりの関係を数字で表すという点で、ベテランが頭の中でやっている「月曜は多め、連休明けはもっと多め」という読みを、紙に書き出したものに近いと考えると分かりやすいと思います。
回帰という言葉は、19世紀のイギリスで、親と子の身長の関係を調べた研究から生まれました。背の高い親の子は親ほど高くならず、平均の方へ戻っていく傾向が見つかり、それを「平均への回帰」と呼んだのが始まりです。いまでは身長に限らず、数字と数字の関係を式にする方法全般を回帰分析と呼び、分析の結果できあがった式を回帰モデルと呼んでいます。表1は、この記事で使う言い換えと、統計の本に出てくる正式な名前の対応です。
| この記事での言い方 | 正式な名前 | 出荷の例 |
|---|---|---|
| 当てたい数字 | 目的変数 | 翌日の出荷ケース数 |
| 手がかりの数字 | 説明変数 | 前日の受注件数、祝日かどうか |
| 手がかりの効き目 | 回帰係数 | 受注1件あたり何ケース増えるか |
| 土台の数 | 切片 | 手がかりがすべて0のときの値 |
| 読みと実際のずれ | 残差 | 予測より何ケース多かったか少なかったか |
手がかりが1つなら単回帰分析、2つ以上なら重回帰分析と呼びます。
単回帰は、手がかり1つで散布図に直線を1本引く方法です
単回帰は、ヨコに手がかり、タテに結果を取った散布図に、点の並びにいちばん沿う直線を1本引く方法です。通販の荷物を扱うセンターなら、前日の夜までに入った受注件数をヨコ、翌日に出したケース数をタテにすると、点はおおむね右上がりに並びます。この点の真ん中を通る線を引けば、受注件数から出荷ケース数を読む式ができあがります。説明のために作った5日分の数字で、実際にやってみたのが表2です。
| 日 | 前日の受注件数 | 実際の出荷 | 直線で読んだ出荷 | ずれ |
|---|---|---|---|---|
| 1日目 | 3,000件 | 3,350ケース | 3,330ケース | +20 |
| 2日目 | 3,500件 | 3,700ケース | 3,765ケース | −65 |
| 3日目 | 4,000件 | 4,300ケース | 4,200ケース | +100 |
| 4日目 | 4,500件 | 4,550ケース | 4,635ケース | −85 |
| 5日目 | 5,000件 | 5,100ケース | 5,070ケース | +30 |
この5日分から引いた直線は「出荷ケース数=720+0.87×前日の受注件数」。ずれは実際の出荷から直線で読んだ出荷を引いた値です。
表2の式は、土台が720ケースで、受注が1件増えるごとに0.87ケース増える、と読みます。受注1件が1ケースにならないのは、1件の注文が1箱にまとまることもあれば、ばら物をまとめて出す荷主もいるからで、この0.87がそのセンターの荷姿のくせを表しています。直線の引き方には決まりがあり、各日のずれを2乗して合計した値が一番小さくなる線を選びます。2乗するのは、上にずれた日と下にずれた日が打ち消し合わないようにするためで、この決め方を最小二乗法と呼びます。
ずれの列を見ると、5日とも100ケース以内に収まっています。ただ、手がかりが受注件数だけなので、祝日明けや月末の締めのように、受注の数では説明できない理由で出荷が増える日が来ると、ずれは一気に大きくなります。ここから先が重回帰の出番です。
重回帰は、祝日や曜日の列を足して、直線で読めない日を減らします
重回帰は、手がかりを2つ以上並べて、それぞれの効き目を同時に割り出す方法です。受注件数のほかに、祝日かどうか、月末かどうか、前週の同じ曜日に何ケース出たか、といった列を横に足していきます。祝日のように数字でない情報は、祝日なら1、そうでなければ0と書いた列にすれば、式の中で「祝日の日はこれだけ減る」という効き目として扱えます。曜日も同じ考え方で、月曜なら1の列、火曜なら1の列、と分けて並べます。表3が、重回帰にかけるときのデータの並べ方です。
| 日付 | 前日の受注件数 | 祝日 | 月末 | 前週の同じ曜日 | 出荷ケース数 |
|---|---|---|---|---|---|
| 10/6(月) | 4,820 | 0 | 0 | 4,610 | 5,240 |
| 10/7(火) | 4,150 | 0 | 0 | 4,080 | 4,470 |
| 10/13(月) | 1,960 | 1 | 0 | 5,240 | 2,130 |
| 10/14(火) | 5,310 | 0 | 0 | 4,470 | 5,780 |
| 10/31(金) | 4,400 | 0 | 1 | 4,250 | 5,120 |
数字は並べ方を示すための例です。祝日と月末の列は、当てはまる日が1、それ以外が0です。
表3の10/13は祝日で、前週の同じ曜日の数字だけを見ると5,000ケースを超えそうに見えますが、実際は半分以下でした。祝日の列があれば、式はこうした日を「祝日だから少ない」と学べます。翌日の10/14は連休明けで受注がたまり、ふだんの火曜より多く出ています。前日の受注件数の列がこの山を拾ってくれるので、手がかりを組み合わせるほど、1本の直線では外れていた日が減っていきます。
手がかりを足すときの目安は、現場の人が理由を説明できる列から入れることです。センター長が毎朝見ている数字、荷主から届く販促の予定、休業日のカレンダーは、たいてい効き目のある手がかりになります。反対に、関係がありそうだからと列をむやみに増やすと、過去の偶然まで覚えてしまい、来週の予測がかえってぶれます。どの手法で需要を読むかの全体像は需要予測の7つの手法を並べた記事にあるので、回帰がその中のどこに位置するかをあわせて見ておくと整理しやすくなります。
サンプルデータでは、前日の通販の受注件数がいちばん効いていました
私たちが作った出荷のサンプルデータで回帰モデルを組むと、効いた順は前日の通販の受注件数、祝日、前年の同じ曜日、前週の同じ曜日でした。データは通販の受注がある出荷センターを想定して作った919日分で、1日あたりの出荷はならして4,200ケースほどです。手がかりには、前日の受注件数、祝日と月末と特売の印、気温と降水量、前週と前年の同じ曜日の出荷など10列を使いました。これをMatrixFlowに読み込ませ、学習に使っていない期間の日で答え合わせをしたのが、図1と図2の画面です。
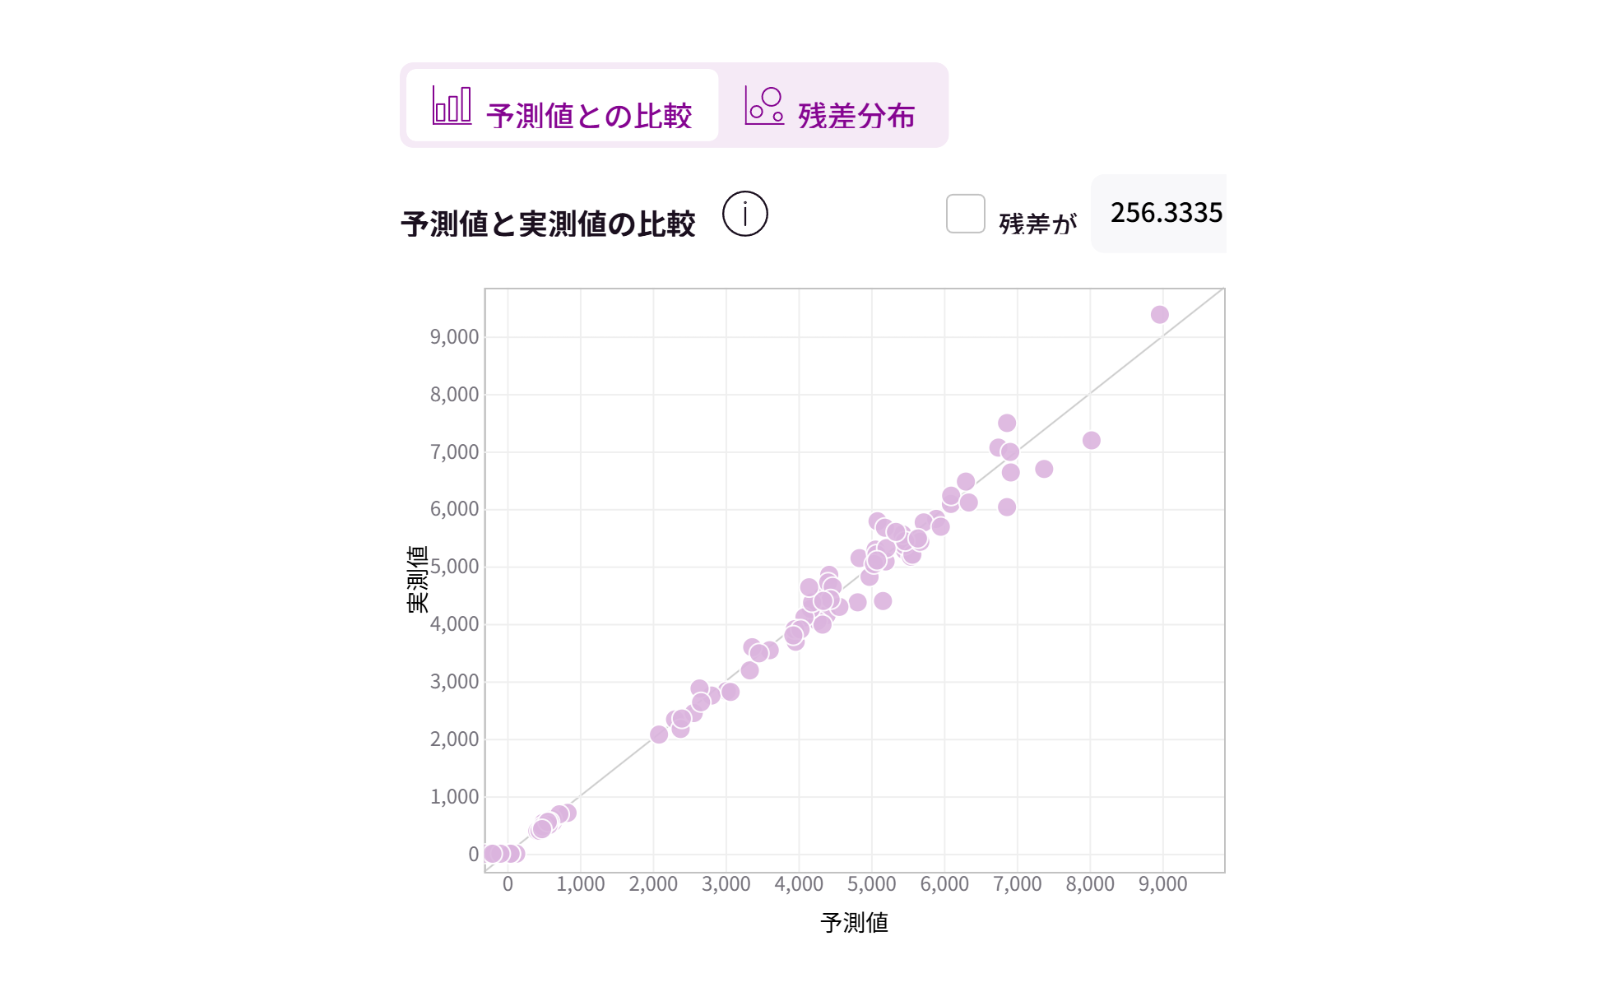
学習に使っていない期間の日で答え合わせをした結果です。左下の点は出荷がほとんどない休業日です。
図1の読み方は、点が斜めの線に乗っているほど読みが当たった日、線から離れた点ほど外れた日です。この例では点がほぼ線の上に並んでいて、外れた日を含めても、ずれはならして1日260ケースほどでした。平均の出荷が4,200ケースなので、6%くらいのずれということになります。出荷が9,000ケースを超えた右上の繁忙日でも、線から大きく外れていないところに、手がかりを組み合わせた効果が出ています。
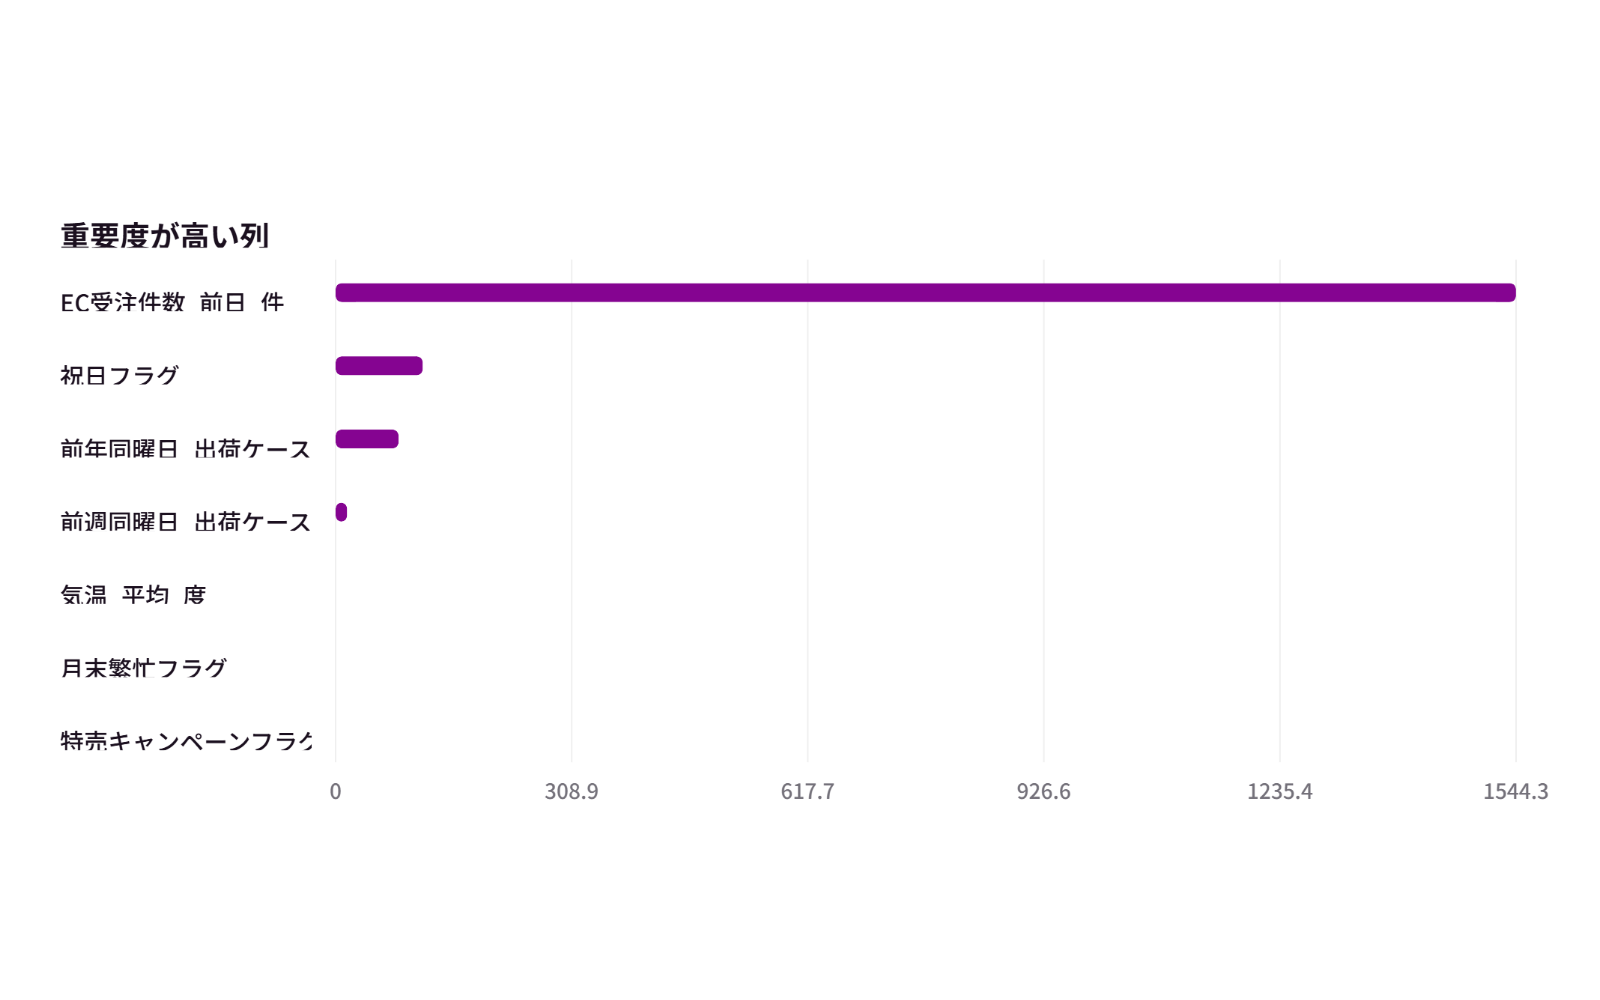
棒が長いほど、予測を決めるのに効いた手がかりです。
図2では、前日の受注件数の棒が飛び抜けて長く、祝日と前年の同じ曜日が続きます。気温や特売の印はほとんど効いていません。このサンプルでは、特売の日も受注件数が先に増えるので、受注の列がその分をすでに拾っていたと考えられます。どの手がかりが効いたかが見えると、予測が外れた日に何を疑えばよいかが分かり、現場で数字の理由を説明しやすくなります。
※ 専門的な言い方をすると、図1はテストデータでの決定係数(R²)が0.986、二乗平均平方根誤差(RMSE)が267.6ケースです。アルゴリズムの自動選択で選ばれたのは最小角回帰(LARS)という重回帰の一種でした。サンプルデータによる結果で、実際の精度はお手元のデータと現場の条件によって変わります。
当たり具合は、1日あたり何ケースずれるかで見ると人数に直せます
回帰モデルの当たり具合は、割合の数字より、1日あたり何ケースずれるかで見るほうが現場の判断に使えます。統計の本では、式が結果の上下の動きをどれだけ説明できたかを0から1の数字で表し、1に近いほどよく当たると教えます。図1の0.986はかなり高い値ですが、この数字だけでは、明日の人数を何人多めに呼べばよいかは分かりません。ずれをケース数で持っておけば、1人が1時間に処理できるケース数で割るだけで、何人時の余裕を見ておけばよいかに直せます。
1人1時間あたり100ケースは計算を示すための仮の値です。お手元の人時生産性に置き換えてください。
図3の例なら、予測どおりに42人時を組み、そこに3人時ほどの余裕を持たせれば、ならした日にはまず足ります。自社の1人1時間あたりの処理量は、人時生産性の求め方で計算できます。ずれは平均の値なので、繁忙期や連休明けのように大きく外れやすい日は、別に記録しておくと安心です。曜日ごとにずれの大きさを並べると、どの曜日の読みが甘いかが見えて、次に足すべき手がかりの見当もつきます。
もう一つ大事なのは、答え合わせを学習に使っていない日で行うことです。式は、学んだ日についてはよく当たるように作られているので、同じ日で確かめると実力より高く見えます。過去の実績のうち直近の2〜3か月を答え合わせ用に取り分け、それより前の期間で式を作ると、来週の予測に近い条件で実力を測れます。
回帰モデルが外すのは、前例のない日と、似た手がかりを並べたときです
回帰モデルは過去にあった関係を延ばして読むので、過去に例のない日は読めません。新しい荷主の立ち上げ直後、初めて行う大型の販促、取引先の物流拠点の移転といった日は、式の中に手本がありません。受注件数が過去の最大を大きく超える日も、直線をそのまま延ばした値になるので、実際には人手や設備の限界で出荷が頭打ちになる、といった現場の事情は反映されません。こうした日は、予測を出したうえで、担当者が分かっている事情を上乗せして決めるのが現実的です。
似た手がかりを並べると、効き目の数字が当てにならなくなります。前週の同じ曜日と前年の同じ曜日のように、ほぼ同じ動きをする列を両方入れると、どちらの効き目なのかを式が切り分けられず、係数が大きく振れたりマイナスになったりします。予測の合計はそれほど崩れなくても、「この手がかりが1増えたら何ケース増える」という読み方はできなくなります。統計ではこの状態を多重共線性と呼びます。似た列はどちらか一方にするか、まとめて1つの列にしておくと、式の中身を現場で説明できる状態に保てます。
もう一つの限界は、回帰が効き目を足し算で表すことです。雨の日だけ通販の受注が伸びる、祝日明けと月末が重なると足し算以上に跳ねる、といった組み合わせの効き方は、そのままでは式に入りません。こうした日が多い現場では、組み合わせを自動で探す機械学習の方法が向いています。機械学習の方法では、木の数や1回で式を直す幅といった設定を学習の前に決める必要があり、その選び方はハイパーパラメータの記事で書いています。当たらない現場に共通する事情は予測の精度をどこまで上げられるかを書いた記事で扱っているので、外れた日の理由が回帰の限界なのか、データの側の問題なのかを見分けるときに役立ちます。
回帰モデルを試す前にそろえておくもの
- 日別の出荷実績が1年分以上、同じ単位(ケース数か行数)で残っている
- 休業日と祝日、月末の締めの日に印を付けた列がある
- 荷主のセールや販促の日を、過去の分も含めて書き出してある
- 前日までに分かる手がかり(受注件数や入荷予定)を日付ごとに並べられる
- 直近の2〜3か月を、答え合わせ用に取り分けておける
Excelで試すなら、分析ツールの回帰分析から始められます
回帰モデルは、Excelに標準で付いている機能だけで組めます。手がかりが1つなら、散布図に近似曲線を追加して「数式を表示する」を選ぶと、表2のような式がグラフの上に出ます。手がかりが複数のときは、アドインの分析ツールを有効にして「回帰分析」を選び、当てたい数字の列と手がかりの列の範囲を指定します。関数で済ませたい場合はLINEST関数が使え、複数の手がかりの効き目と土台の数を一度に返し、当たり具合の数字も出せます。図4が、Excelで試すときの流れです。
流れの中でいちばん時間がかかるのは、実は回帰分析そのものではなく、最初の列をそろえる作業です。過去の販促の日や休業日が記録に残っていないと、そこを掘り起こすだけで数日かかることもあります。Excelで予測を組むときの関数の選び方と、行数や更新の手間で行き詰まる点はエクセルで需要予測をする記事にまとめています。センターや荷主が増えて式を何本も持つようになったら、手作業での更新は難しくなるので、出荷物量から必要な人員を決める仕組みのように、予測から人数までを毎日自動で出す形を考える時期です。
よくある質問
回帰分析と回帰モデルは、どう違うのですか
回帰分析は、数字と数字の関係を調べて式にする作業の名前で、回帰モデルはその結果できあがった式のことです。現場では、予測に使う式そのものを指して回帰モデルと呼ぶことが多くなっています。
何日分のデータがあれば回帰モデルを作れますか
曜日と祝日の効き目を読ませたいなら、祝日や年末年始が一通り入る1年分以上が目安になります。手がかりの列が多いほど必要な日数も増えるので、最初は効き目のありそうな3〜4列に絞って作り、答え合わせをしながら足していくと失敗が少なくなります。
AIの予測と回帰モデルは別のものですか
回帰モデルも、AIの予測の中で使われる方法の一つです。AIの予測ツールは、回帰を含むいくつもの方法を試して当たり具合の良いものを選んでくれる、と考えると近いと思います。この記事のサンプルデータでも、自動で選ばれたのは重回帰の一種でした。
あわせて読みたい
- 需要予測の手法は7つ。出荷物量では、前週同曜日を物差しにして選ぶ52週前の同じ曜日を写すと、2026年の文化の日の予測に去年の祝日明けの山が入ります。前年同期から機械学習まで7つの手法を出荷物量に当てはめ、最初の1つを選ぶ順番まで。
- 人時生産性とは。計算式と、上げ方の順番計算式は「物量÷人時」。数字だけを追うと、検品の手抜きや隠れ残業が起きます。崩れずに上げるための5つの順番。
- ハイパーパラメータとは。需要予測モデルの精度を左右する設定LightGBMは何も決めなければ学習率0.1・葉31・繰り返し100回で学びます。この設定を変える意味と、過去から未来の順で答え合わせする選び方、探す3つの方法まで。
出典・参考:Francis Galton「Regression towards Mediocrity in Hereditary Stature」(The Journal of the Anthropological Institute of Great Britain and Ireland, Vol.15, 1886)/埼玉県 統計課「統計FAQ 回帰分析とは」/Microsoft サポート「LINEST 関数」/Bradley Efron ほか「Least Angle Regression」(The Annals of Statistics, Vol.32 No.2, 2004)。サンプルデータの結果は、MatrixFlowで作成した架空の出荷データによるものです。この記事は2026年11月時点で確認できた情報をもとに書いています。