このセクションの他の記事
推論用データセットの作り方
推論用データセットの作り方をデータ種類ごとに解説します。
学習用データセットについては、学習用データセットの作り方 をご覧ください。
■数値や文字列データの表形式CSVファイル
■単語や文章を含む表形式CSVファイルの作成(自然言語を含む構造化データ)
<データの作成方法>
学習用データセットに準じます。
<データ作成時の留意事項>
学習用データセットに準じますが、さらに以下についてご留意ください。
・列名は学習用データセットとまったく同じに設定します。(完全一致)
推論は、AIモデル構築時に指定した[学習に使用する列]の列名を検索してデータを読み込みます。そのため、推論用データセット内に必要な列が見つからないと「データセットに推論に必要な列または、前処理に必要な列が不足しています」とエラーが表示されて推論できません。
このとき、画面右の「不足している列」に、足りない列名がすべて表示されます。表示された列を推論用データセットに追加してください。
・推論用データセットに[予測する列]は不要です。
学習用データセットには、各サンプルの正解にあたる[予測する列]が必須ですが、推論用データセットには不要です。
■文書や画像のZIPファイルの作成
文書データと画像データのZIPファイルに、フォルダ構造やフォルダ名のルールがあるのは学習用データセットと同様ですが、推論用データセットには「labelsフォルダ」は不要です。
フォルダ構造が適切ではない場合、MatrixFlowは正常に動作できず、推論に失敗します。
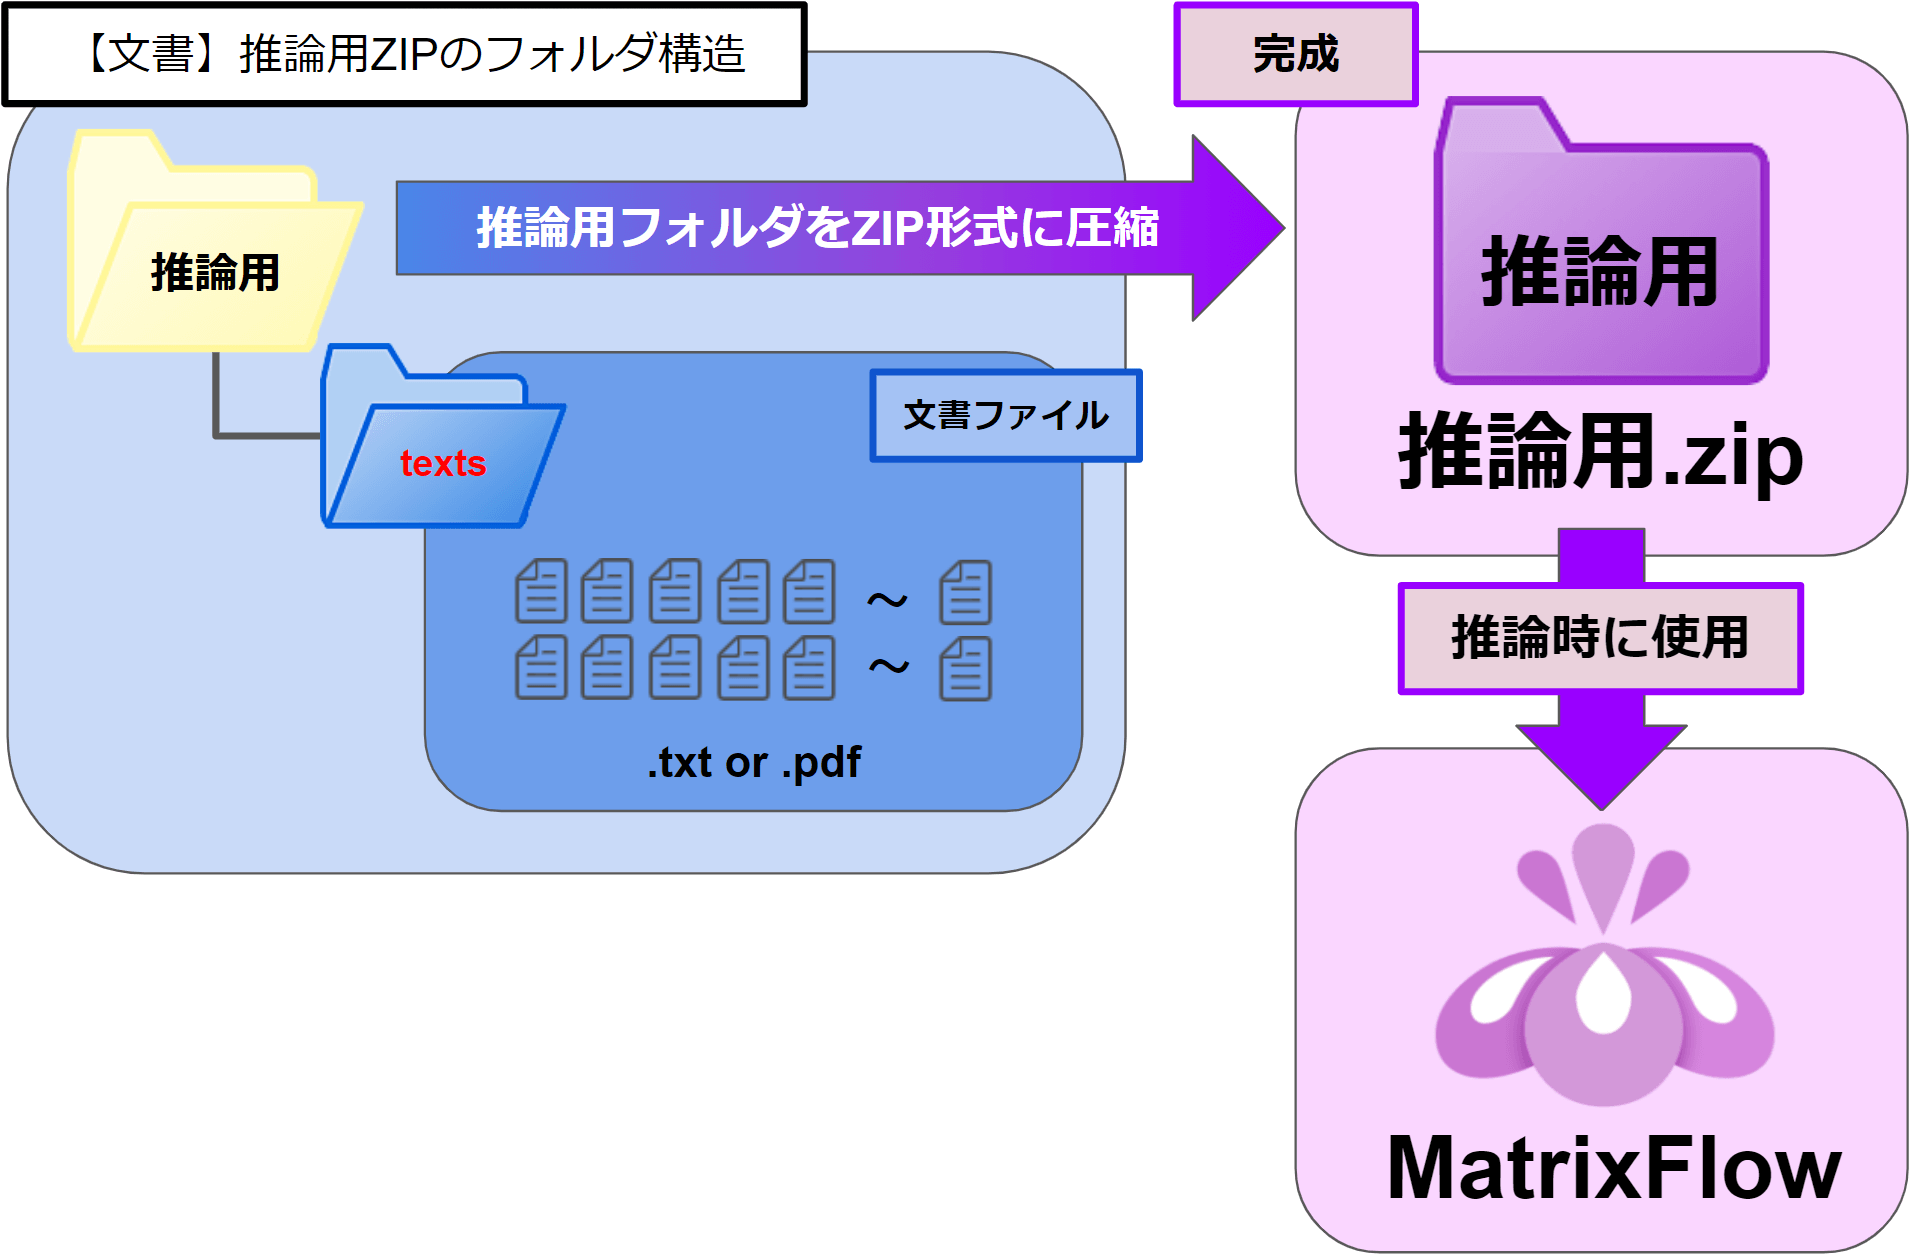
▶文書データのZIPファイル構造
<ZIPファイル内のフォルダ構造>
任意のフォルダ \ 「texts」フォルダ \ 文書ファイル(.txt, .pdf)
・最上位階層のフォルダ名は任意です。
・2階層目のフォルダ名は「texts」固定です。
・「texts」フォルダの中に文書データの .txtファイルや .pdfファイルを配置します。
最上位階層のフォルダをZIP圧縮します。
▶画像データのZIPファイル構造
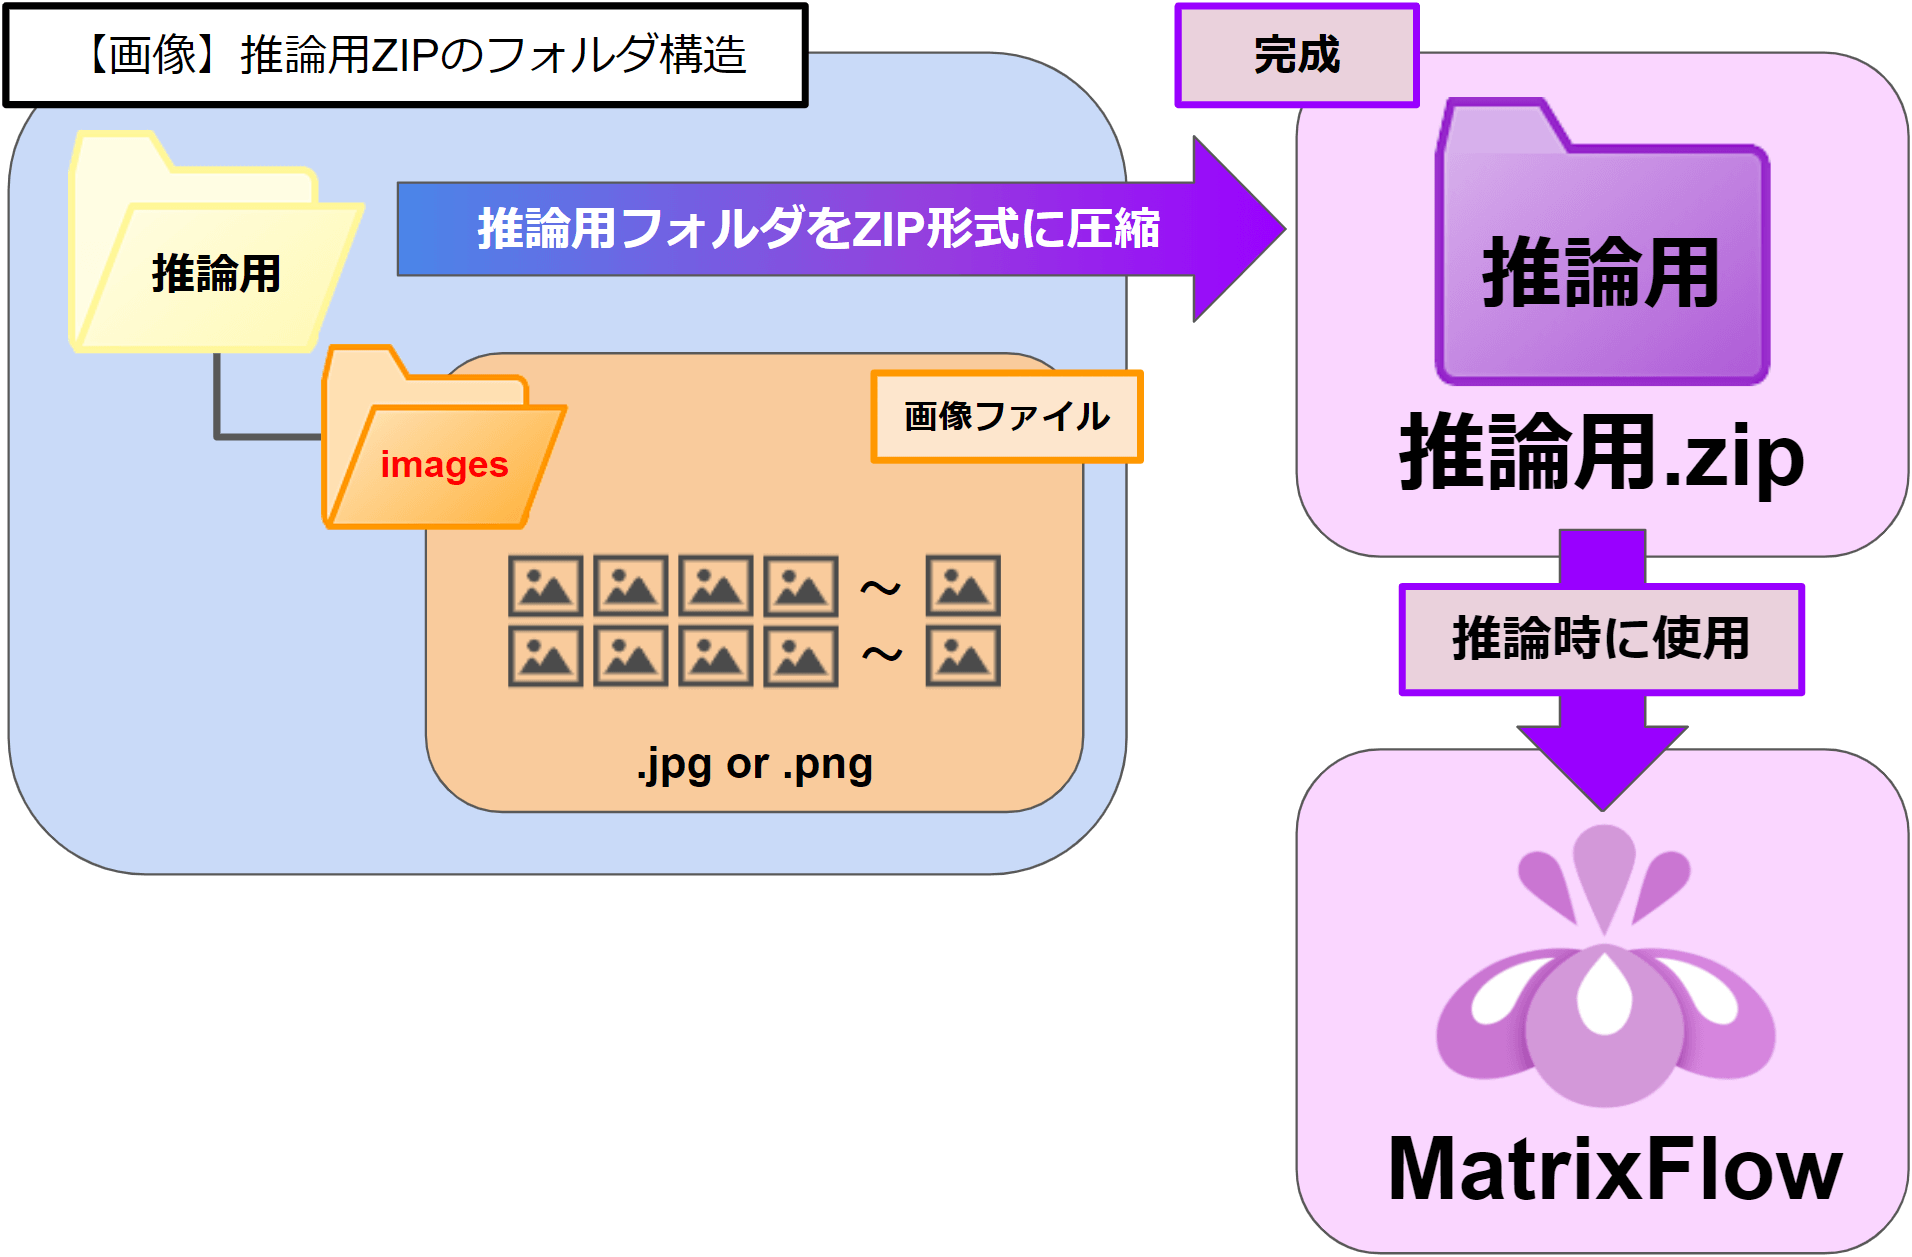
<ZIPファイル内のフォルダ構造>
任意のフォルダ \ 「images」フォルダ \ 画像ファイル(.jpg, .png)
・最上位階層のフォルダ名は任意です。
・2階層目のフォルダ名は「images」固定です。
・「images」フォルダの中に画像データの .jpgファイルや. pngファイルを配置します。
最上位階層のフォルダをZIP圧縮します。
■文書データ、画像データのZIPファイル共通仕様
・ZIPファイル名、フォルダ名に使える文字列
いずれも、半角英数字(a-z, A-Z, 0-9)とアンダースコア( _ )のみです。
特殊文字や全角文字は使用できません。
・推論用のフォルダ構造に、ラベル(分類カテゴリ)のフォルダは不要です。
学習用データセットには、分類カテゴリに相当するフォルダがあったり、分類カテゴリが記述されたファイルを格納するlabelsフォルダが必要ですが、推論用データセットには不要です。
■1ファイルのみで推論を行う
文書データと画像データの分類に限り、ZIPファイルを作成せずに1ファイルのみ投入して推論を行うことができます。
1ファイルで推論できるファイルの種類は次の通りです。
PDFファイルは対応していませんのでご注意ください。
・文書データ(.txt)
・画像データ(.jpg, .png)
■MFTransformerV2(時系列)特有の作り方
レシピブロック「MFTransformerV2」を使用した予測を行う場合、特殊な推論データセットを作ります。
MFTransformerV2で使用する学習データセットと推論データセットの比較図を用いて解説します。
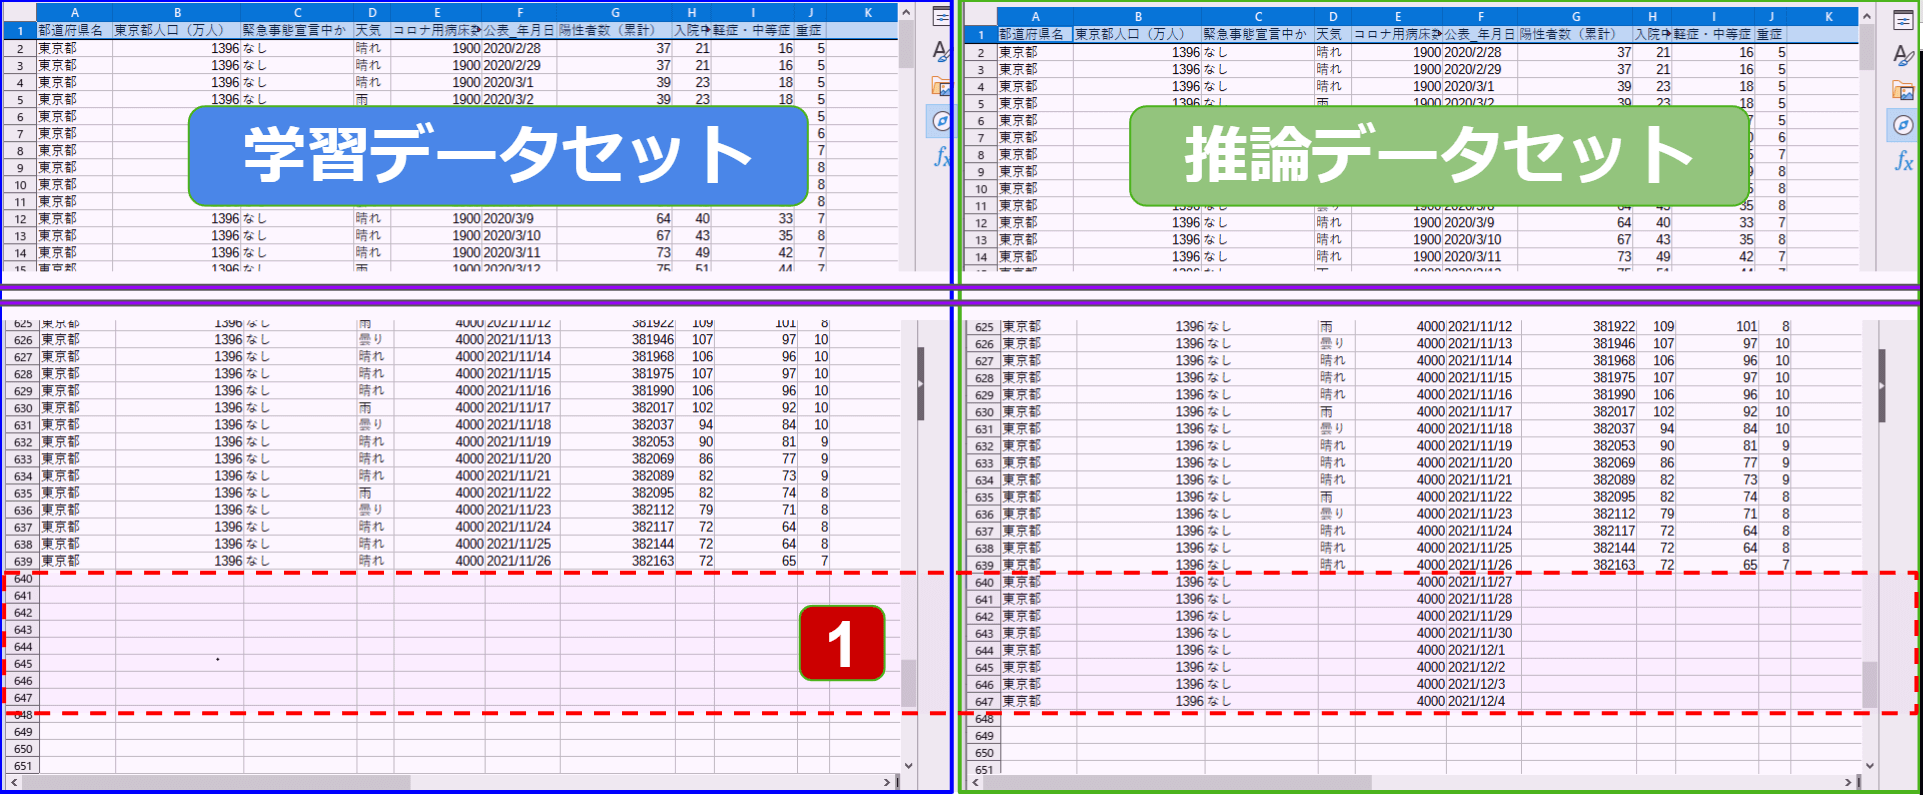
左が「学習データセット」右が「推論データセット」です。途中の行は、省略しています。
<時間列と、その間隔について>
時間のデータ(画像では「公表_年月日」列)は昇順に、等間隔にデータを入力します。
推論データセットは、学習データセットと同じ間隔にする必要があります。
同一のデータセット内で別々の間隔を使用することはできません。
画像上は日間隔ですが、年月日時分秒が利用できます。
<推論データセットの特徴について>
1.画像の640行から647行(8行分)が、予測したい行です。
都道府県列や東京都人口(万人)などの一部の列が予め入力されています。これは、学習の画面にて「予測時に設定できる値か」を「設定できる」にしたためです。
MFTransformerV2は予測時に設定できる値も加味して、予測の結果を出力します。
一方、「予測時に設定できる値か」を「設定できない」にした箇所は空白にします。
MFTransformerV2の推論データセットは「学習データセットに予測したい行のデータを加えたもの」と覚えて頂けますと幸いです。
<空欄にする場所>
推論データセットでは、列の種類ごとに空欄にできる場所が決まっています。ルールと違う場所が空欄だと、推論できません。
| 列の種類 | 空欄のルール |
|---|---|
| 予測する列 | 末尾の行だけを空欄にします。末尾の連続した空欄の行数が、予測する行数になります。途中の行を空欄にしたり、空欄の行を置かなかったりすると推論できません。 |
| 予測時に設定できる値に「設定できる」を選んだ列 | 空欄を含められません。予測したい行にも、あらかじめ決まっている値を入れてください。 |
| 予測時に設定できる値に「設定できない」を選んだ列 | 予測する列と同じ末尾の行数を空欄にします。それ以外の行は空欄にできません。この空欄には、処理の中で直前の値が入ります。 |
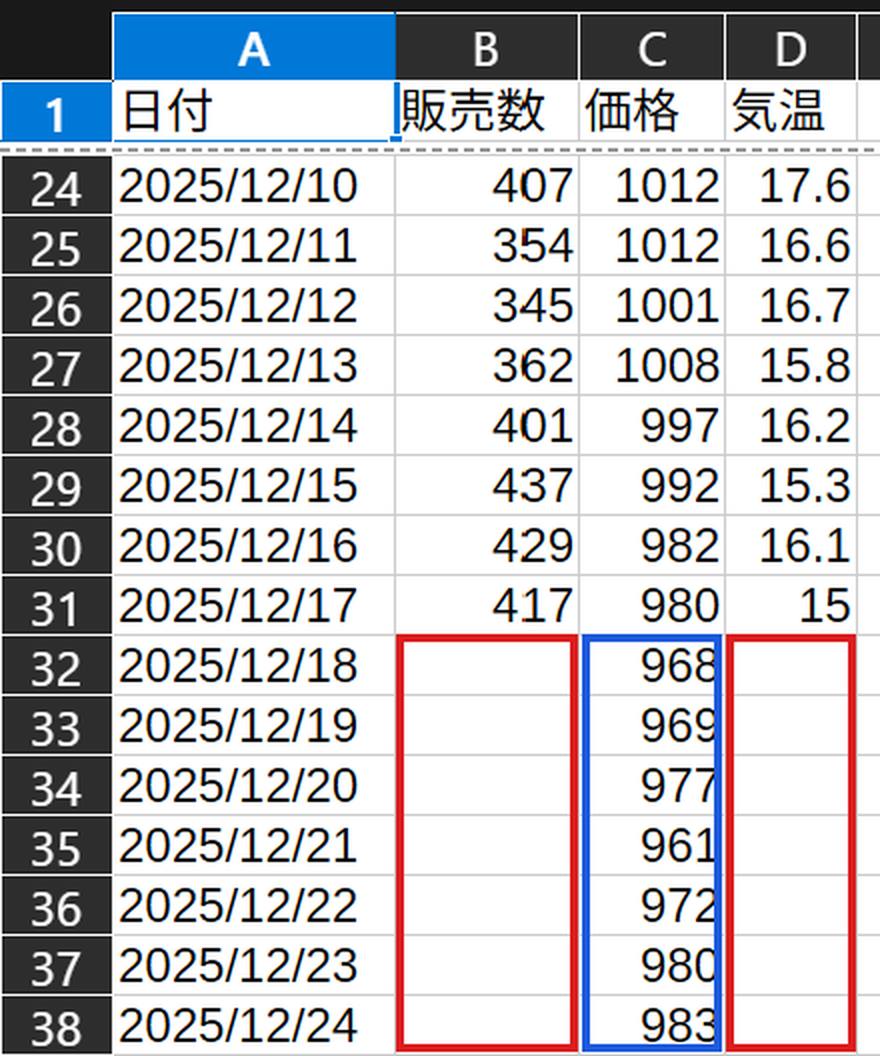
右の図は、予測する列「販売数」、「設定できる」列「価格」、「設定できない」列「気温」のデータで、7行先まで予測する推論データセットの例です。
赤枠が空欄にする場所、青枠が値を入れる場所です。
※AIが予測するのは「予測する列」だけです。「設定できない」列の末尾の空欄は予測されません。
<学習時に無かったカテゴリの値を含む場合>
カテゴリーデータの列に、学習用データセットに無かった値があっても、推論はできます。
ただし、その値の行では、その列が予測に使われません。推論結果画面に次の警告が表示されます。
「学習時に存在しなかったカテゴリの値が推論データに含まれています。その値の行では、対象の列が予測に寄与しない状態で推論されています。」
予測の精度が下がることがあるため、できるだけ学習時と同じ値を使ってください。
<推論できないとき>
表示されるメッセージと直し方は、時系列予測(MFTransformerV2)で表示されるメッセージと対処 をご覧ください。